Bu sayfadaki yazılar
Sayfanın metni
Sayfa 17
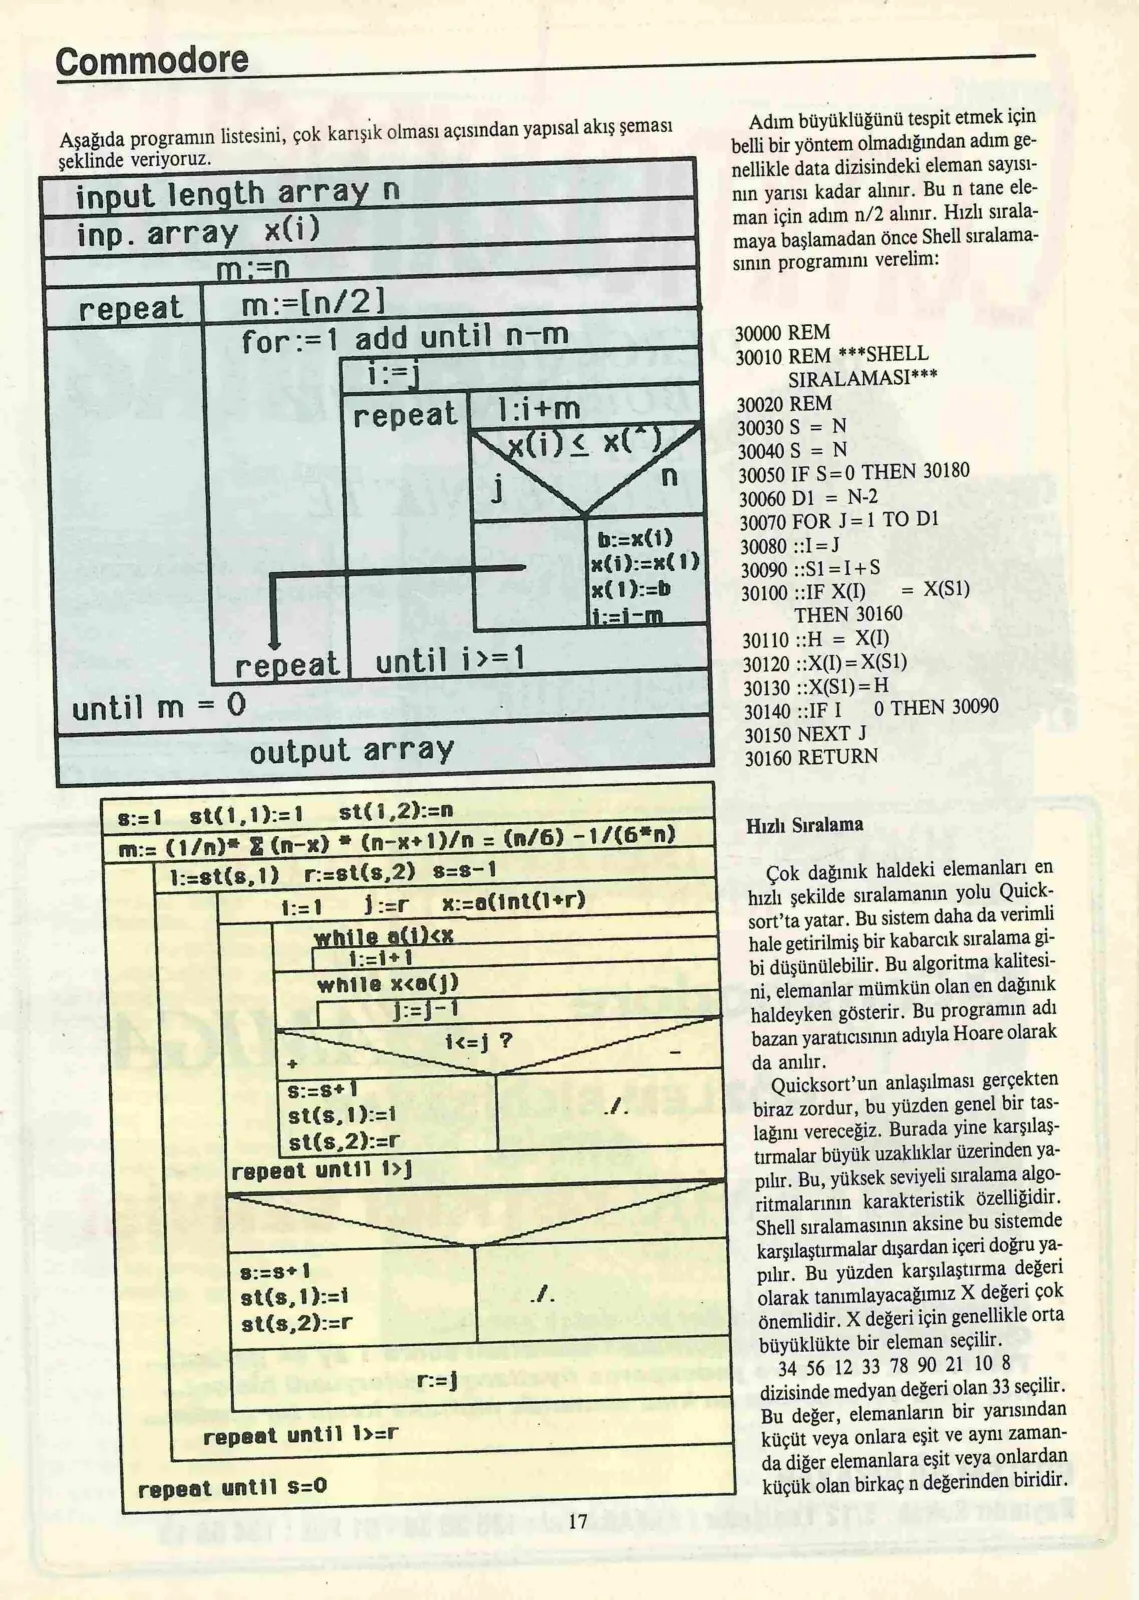
Aşağıda programın listesini, çok karışık olması açısından yapısal akış şeması Adım büyüklüğünü tespit etmek için şeklinde veriyoruz. belli bir yöntem olmadığından adım genellikle data dizisindeki eleman sayısının yarısı kadar alınır. Bu n tane eleman için adım n/2 alınır. Hızlı sıralamaya başlamadan önce Shell sıralamasının programını verelim:
30000 REM
30010 REM ***SHELL SIRALAMASI*** 30020 REM 300308 - N 300408 - N 30050 IF S-0 THEN 30180 30060 DI — N-2 30070 FOR J-1 TO Dİ 30080 J 30000 ::81-1-4- 8 x(1):>b 30100 ::1F — — X(SI) izİZM THEN 30160
30110 ::H — X() 30120 — X(S1) 30130 -H 30140 ::IFI — 0 THEN 30090 30150 NEXT J 30160 RETURN
s:ızi Hızlı Sıralama
Çok dağınık haldeki elemanları en hızlı şekilde sıralamanın yolu Quicksort'ta yatar. Bu sistem daha da verimli hale getirilmiş bir kabarcık sıralama gibi düşünülebilir. Bu algoritma kalitesini, elemanlar mümkün olan en dağınık haldeyken gösterir. Bu programın adı bazen yaratıcısının adıyla Hoare olarak da anılır. Quicksort'un anlaşılması gerçekten biraz zordur, bu yüzden genel bir taslağını vereceğiz. Burada yine karşılaştırmalar büyük uzaklıklar üzerinden yapılır. Bu, yüksek seviyeli sıralama algoritmalarının karakteristik özelliğidir. Shell sıralamasının aksine bu sistemde karşılaştırmalar dışardan içeri doğru yapılır. Bu yüzden karşılaştırma değeri olarak tanımlayacağımız X değeri çok önemlidir. X değeri için genellikle orta büyüklükte bir eleman seçilir. 34 56 12 33 78 90 21 10 8 dizisinde medyan değeri olan 33 seçilir. Bu değer, elemanların bir yarısından küçük veya onlara eşit ve aynı zamanda diğer elemanlara eşit veya onlardan küçük olan birkaç değerden biridir.
repeat until 1>-r
repeat until s-0 17
Klavyeyle gezinmek için ← ve → tuşları.
Sayfa 16
Ma aaa sayısı (n-1)'e düşer. Doğrusal Sıralama
Bu yöntem “araya sıkıştırmalı sıralama” prensibine dayanır. Örneğin siz bir dizi kartı dizerken istediğiniz kartları diğerlerinin arasına sıkıştırırsınız. Böylece zaten gereken yerde bulunan elemanların yeri boşu boşuna değişmez. Eğer data grubu biraz sıralıysa bu sistem çok hızlı işler. Eğer grup çok dağınıksa sıralama için büyük zaman harcanır. Doğrusal sıralama rutini aşağıdaki gibidir:
30000 REM 30005 REM ***DOĞRUSAL SIRALAMA*** 30010 REM 30020 FOR 1-2 TO N 30030 ::A(0) — A(I)
30040 ::B — I-I 30050 ::1F A(0) — — A(B) THEN GOTO 30090 30060 ::A(B-- 1) — A(0) 30070 ::B — 30080 ::1F B 0 THEN
Di Ve va er Ü
GOTO 30050 30090 ::A(B4 1) — A(0) 30100 NEXT I 30110 RETURN
Gördüğünüz gibi doğrusal sıralama her işinizi en kısa zamanda görecek bir program değildir. Aslında gerçekten fazla önemi yoktur. Daha önce bahsettiğimiz geliştirilmiş kabarcık sıralama çok daha yararlıdır. Toplam işlem sayısı (n*n + 3*n - 4)/2'dir.
Shell Sıralaması
Biraz daha verimli olmasına rağmen anlaşılması daha zor olan bir sıralama sistemi olan Shell, 1959 yılında D.L. Shell tarafından önerilmiştir. Bu metodda da direkt bir yaklaşım izleyeceğiz. Sıralanacak olan değerler komşu değerlerle değil uzaktaki değerlerle karşılaştırılacaktır. Shell sıralaması aslında “araya sıkıştırma” yönteminin değişik bir uygulamasıdır. Ancak sebebi bilinmeyen nedenlerle en verimli adım büyüklüğü tespiti hâlâ yapılamamaktadır. Shell sıralamasının anlatımı için uygulanabilecek en kolay yol aşağıda verilen yapısal akış şemasıdır. Bu sistemde data elemanları gittikçe azalan uzaklıktaki diğer elemanlarla karşılaştırılır ve gerektiğinde yer değiştirilir. Yavaş yavaş en küçük uzaklığa erişilir ve (umarız) elemanlar sıralanmış olur.